登录社区云,与社区用户共同成长
邀请您加入社区
一个完全自动化的 RAG (检索增强生成) 数据知识库构建工作流你只需要输入一个网站地图 (sitemap) 的网址,按下“执行”,然后就可以泡杯咖啡,静静地看着电脑帮你完成所有工作:自动抓取网页 -\ AI 清洗整理 -\ 存成本地 Markdown 文件。
Retrieval Augmented Generation,检索增强生成。是一种结合了信息检索技术和大型语言模型提示功能的框架。它通过从数据源检索信息来辅助LLM生成答案,提高了模型在知识密集型任务中的准确性和可信度。
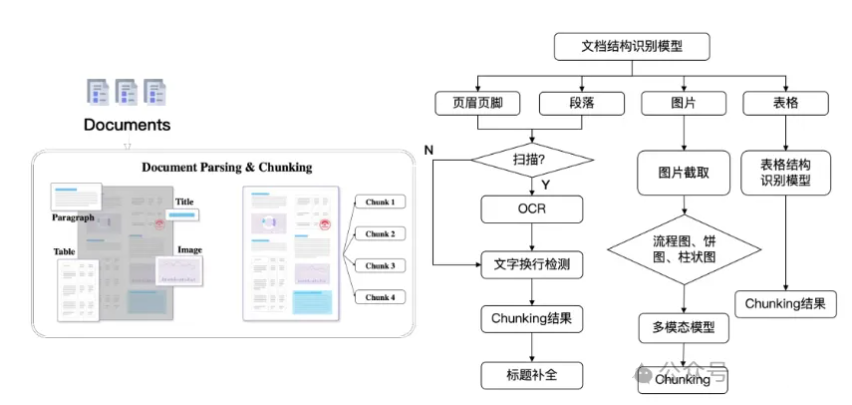
在本篇文章中,介绍了实现多模态RAG的三种方法,基于语义提取、基于视觉语义模型VLM、基于多模态数据融合(分离检索)。当然,没有一种方法是完美的,每种方法都有自己的优势和缺点,准确度高、泛化性好的方案,势必训练成本高。对于有钱有资源的基座大模型企业,基于视觉语义模型VLM的方案无疑是更合适的选择。而对于面向应用层的初创公司,分离检索方法则更为适合。
关于前面已经介绍了(供参考),这次来看看ColPali实践。
通过上述架构与技术,我们解决了多模态文档处理中的三大核心问题:解析复杂性(工具选型)、索引低效性(差异化处理)、生成准确性(递归检索)。工具链适配:根据文档类型选择解析工具 —— 扫描件优先 Open-Parse(OCR 支持),结构化报告优先 LlamaParse(自动摘要),复杂文档优先 Unstructured(深度解析)分阶段测试:先验证单模态处理流程(如纯文本 / 纯表格文档),再逐步集